说明
本文描述问题及解决方法同样适用于 腾讯云 Elasticsearch Service(ES)。
前言
最近在回顾一些曾经在 ES 上踩过的坑,想起了这么一个问题:Elasticsearch 索引突然无法写入新文档了,日志里报错说文档数量超过了限制。这个问题在 7.x 版本的集群中尤其常见,因为从 7.x 开始,Elasticsearch 默认索引只有 1 个分片。今天就来回顾一下这个问题的来龙去脉。
问题现象
当索引的单个分片文档数达到上限时,会看到类似这样的错误:
Number of documents in the index can't exceed [2147483519]这个数字看起来很眼熟对吧?没错,它非常接近 Java 的 Integer.MAX_VALUE(2147483647)。实际上,这个限制来自于 Lucene 的 IndexWriter.MAX_DOCS。
为什么会有这个限制?
这个限制其实是 Lucene 层面的硬性约束。我们来看看源码中的关键部分:
在 InternalEngine.java 中,有这样一段代码:
private Exception tryAcquireInFlightDocs(Operation operation, int addingDocs) {
    assert operation.origin() == Operation.Origin.PRIMARY : operation;
    assert operation.seqNo() == SequenceNumbers.UNASSIGNED_SEQ_NO : operation;
    assert addingDocs > 0 : addingDocs;
    final long totalDocs = indexWriter.getPendingNumDocs() + inFlightDocCount.addAndGet(addingDocs);
    if (totalDocs > maxDocs) {
        releaseInFlightDocs(addingDocs);
        return new IllegalArgumentException("Number of documents in the index can't exceed [" + maxDocs + "]");
    } else {
        return null;
    }
}
这里的 maxDocs 默认值就是 IndexWriter.MAX_DOCS,也就是 2147483519(约 21.47 亿)。
为什么 7.x 版本更容易遇到?
在 Elasticsearch 7.x 之前,默认索引会创建 5 个主分片。但从 7.x 开始,为了优化资源使用和提升性能,默认改为只创建 1 个主分片。
这意味着:
- 6.x 及之前:21.47 亿 × 5 = 约 107 亿文档才会遇到问题
- 7.x 及之后:21.47 亿文档就会遇到问题
对于日志类、时序类数据,如果没有合理规划索引策略,很容易就会触碰到这个天花板。
代码流程分析
让我们通过一个流程图来理解文档写入时的检查机制:
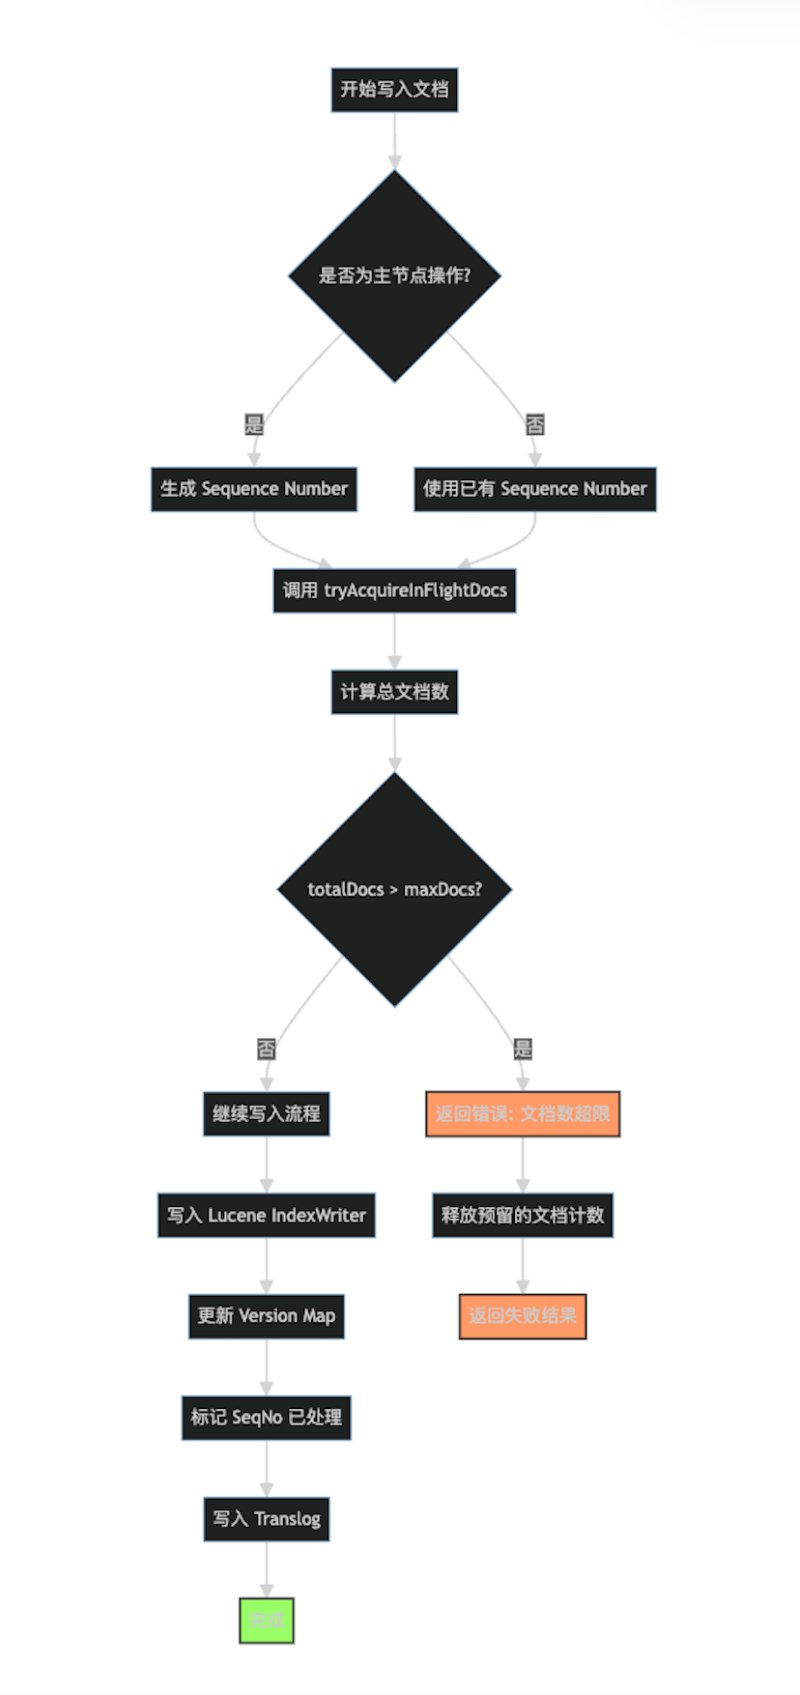
关键代码解析
1. 文档数量检查(InternalEngine.java)
private final AtomicLong inFlightDocCount = new AtomicLong();
private final int maxDocs;

public InternalEngine(EngineConfig engineConfig) {
    this(engineConfig, IndexWriter.MAX_DOCS, LocalCheckpointTracker::new);
}引擎初始化时,maxDocs 被设置为 IndexWriter.MAX_DOCS。在每次写入操作前,都会检查:
final long totalDocs = indexWriter.getPendingNumDocs() + inFlightDocCount.addAndGet(addingDocs);
if (totalDocs > maxDocs) {
    // 超限,拒绝写入
}
这里有两个计数器:
indexWriter.getPendingNumDocs():IndexWriter 中待提交的文档数inFlightDocCount:正在处理中但还未提交到 IndexWriter 的文档数
2. Shrink 操作的检查(TransportResizeAction.java)
在执行索引收缩(shrink)操作时,也会检查合并后的分片是否会超过限制:
for (int i = 0; i < numShards; i++) {
    if (resizeRequest.getResizeType() == ResizeType.SHRINK) {
        Set<ShardId> shardIds = IndexMetadata.selectShrinkShards(i, sourceMetadata, numShards);
        long count = 0;
        for (ShardId id : shardIds) {
            DocsStats docsStats = perShardDocStats.apply(id.id());
            if (docsStats != null) {
                count += docsStats.getCount();
            }
            if (count > IndexWriter.MAX_DOCS) {
                throw new IllegalStateException("Can't merge index with more than [" + IndexWriter.MAX_DOCS
                    + "] docs - too many documents in shards " + shardIds);
            }
        }
    }
}
这确保了在 shrink 操作时,不会将多个分片合并成一个超过限制的大分片。
解决方案
方案一:增加分片数(推荐用于新索引)
对于新创建的索引,可以在索引模板中设置合适的分片数:
PUT _index_template/my_template
{
  "index_patterns": ["logs-*"],
  "template": {
    "settings": {
      "number_of_shards": 3,
      "number_of_replicas": 1
    }
  }
}注意:这个设置只对新创建的索引生效,已存在的索引不会受影响。
方案二:使用 Split API(用于已存在的索引)
对于已经达到限制的索引,可以使用 Split API 来增加分片数:
# 1. 先将索引设置为只读
PUT /my_index/_settings
{
  "settings": {
    "index.blocks.write": true
  }
}

# 2. 执行 split 操作
POST /my_index/_split/my_index_new
{
  "settings": {
    "index.number_of_shards": 3
  }
}

# 3. 等待 split 完成后,可以删除旧索引
DELETE /my_index重要提示:
- Split 操作要求新分片数必须是原分片数的倍数
- Split 过程会消耗大量磁盘空间和 I/O 资源
- 建议在业务低峰期执行
方案三:使用索引生命周期管理(ILM)
对于日志类、时序类数据,最佳实践是使用 ILM 自动管理索引:
PUT _ilm/policy/logs_policy
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": {
            "max_docs": 2000000000,
            "max_age": "7d",
            "max_size": "50gb"
          }
        }
      },
      "delete": {
        "min_age": "30d",
        "actions": {
          "delete": {}
        }
      }
    }
  }
}
这样可以在文档数接近限制前自动滚动到新索引,避免触碰天花板。
最佳实践建议
- 合理规划分片数:根据数据量和增长速度,预估合适的分片数。一般建议单个分片文档数控制在 10 亿以内。
- 使用索引模板:为不同类型的数据设置不同的索引模板,避免使用默认的 1 个分片。
- 监控文档数量:定期监控各分片的文档数,在接近限制前采取措施。可以使用以下 API:
GET /_cat/shards?v&h=index,shard,docs&s=docs:desc- 时序数据使用 ILM:对于日志、监控等时序数据,强烈建议使用 ILM 自动管理索引生命周期。
- 避免单分片过大:即使没有达到文档数限制,单个分片过大(如超过 50GB)也会影响性能和恢复速度。
总结
Elasticsearch 的单分片文档数限制是 Lucene 层面的硬性约束,这个限制在 7.x 版本中因为默认分片数的改变而变得更容易触碰。理解这个限制的原理和检查机制,可以帮助我们更好地规划索引策略,避免生产环境中出现意外。
记住几个关键点:
- 单分片最大文档数:2147483519(约 21.47 亿)
- 7.x 默认只有 1 个分片,更容易达到限制
- 提前规划比事后补救更重要
- 对于时序数据,ILM 是最佳选择
希望这篇文章能帮助你更好地理解和应对这个问题。如果你的集群中有大量数据,不妨现在就检查一下各个分片的文档数吧!