别再跟单个ChatGPT死磕了——用Multi-Agent搭一支AI团队,效率直接翻3倍
大家好,我是摘星,今天我们来聊聊一个正在悄悄改变整个AI开发范式的东西——Multi-Agent多智能体协作。
上周有个做独立开发的朋友跟我吐槽:他用GPT-4写了一个竞品分析报告,花了整整一个下午——不是模型不够聪明,而是他得手动把搜索结果粘贴进去、让模型分析、再手动把分析结果喂给另一个Prompt生成图表、最后自己排版。我突然意识到,很多人对AI的用法还停留在"单轮对话"阶段,就像你明明可以指挥一个团队,却非要自己一个人跑完全流程。2026年最值得投入学习的技术,不是哪个新模型,而是Multi-Agent——让多个AI智能体像一支真正的团队一样分工协作、自动完成复杂任务。这篇文章会从架构原理、框架选型到实战代码,完整拆解Multi-Agent的技术内核,帮你在最短时间内搞懂怎么搭一支自己的AI团队。
一、什么是Multi-Agent?为什么2026年是爆发元年?
从单打独斗到团队协作
理解Multi-Agent之前,先搞清楚什么是Agent(智能体)。简单说,Agent = LLM + 感知 + 规划 + 工具调用 + 记忆。一个Agent不仅能聊天,还能主动搜索信息、调用API、执行代码、读写文件——它具备了"代理性"(Agency),能代替你完成一整条任务链。
Multi-Agent就是让多个这样的Agent协同工作。每个Agent有自己的角色、专业能力和工具集,它们通过消息传递和协议协调来共同完成一个复杂目标。这就像一个公司里有产品经理、设计师、工程师、QA——每个人各司其职,通过标准化流程协作交付产品。
为什么2026年是爆发点?三个关键条件同时成熟了:
第一,模型能力到位了。 2025年底到2026年初,主流大模型(GPT-4.6、Claude 4.6、Qwen3、GLM-5)的Function Calling和推理能力大幅提升,Agent的"工具使用"和"多步规划"准确率从70%出头飙到90%以上。这意味着Agent终于可以可靠地执行复杂任务链了,不会动不动就"翻车"。
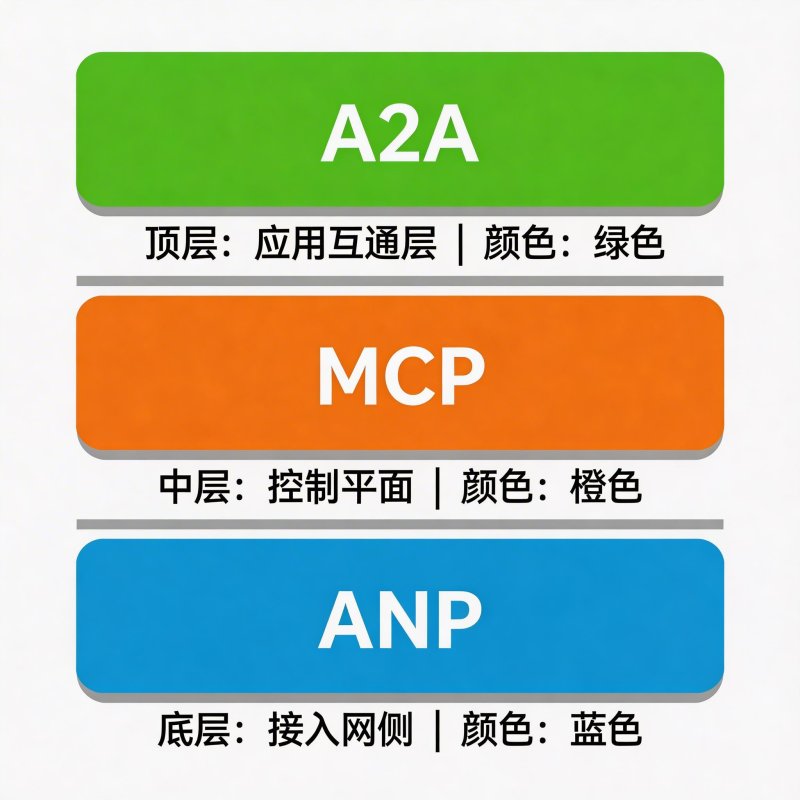
第二,协议标准统一了。 Anthropic的MCP(Model Context Protocol)解决了Agent调用外部工具的标准化问题;Google在2026年初发布的A2A(Agent-to-Agent Protocol)解决了Agent之间如何通信的问题;加上ANP(Agent Network Protocol)提供网络层的发现与路由,三层协议栈补齐了Agent互联的技术底座。
第三,企业需求倒逼了。 清华大学发布的《2026年中国AI发展趋势前瞻》显示,中国AI核心产业规模预计突破1.2万亿元。企业不满足于"能聊天"的AI了,他们要的是"能办事"的AI。零一万物发布的六大预判中,第一条就是"2026年是企业多智能体元年"——从"事务管理"转向"结果管理",让多个Agent像真实团队一样分工协作、相互检查。
实际数据也很能说明问题:在软件开发和自动化审计场景下,多Agent协作的效率比单Agent循环高出约300%;引入"审计Agent"或"批评者Agent"后,大模型幻觉率从15%降到1%以下;通过将任务分配给不同参数规模的模型(小模型做分类,大模型做推理),Token成本能降低40%-60%。
二、核心技术架构:ReAct + Function Calling + 协议层
要搭建Multi-Agent系统,你得先理解三个核心概念:单个Agent怎么工作(ReAct模式)、Agent怎么调用工具(Function Calling)、Agent之间怎么通信(协议层)。
2.1 ReAct模式:让AI学会"边想边做"
ReAct(Reasoning + Acting)是目前最主流的Agent执行模式。它的核心思想很简单:让大模型交替进行"思考"和"行动"——先推理当前该干什么,然后调用工具执行,拿到结果后再推理下一步,如此循环直到任务完成。
一个完整的ReAct循环包含四个阶段:
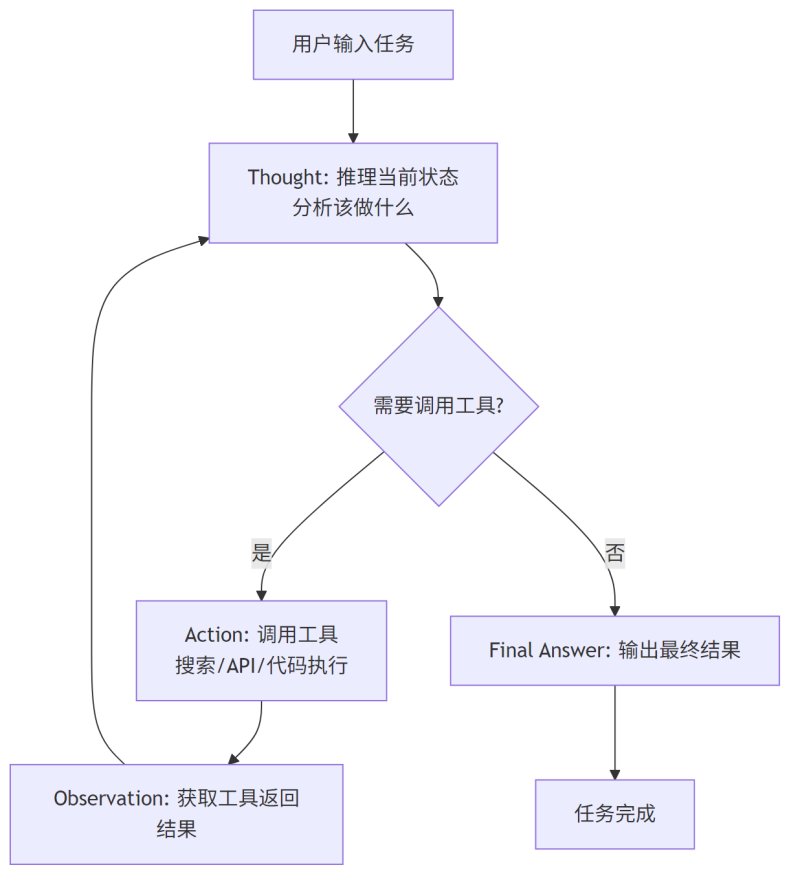
这个流程图展示了ReAct的核心循环:Thought → Action → Observation → Thought → ... → Final Answer。它跟传统的"一次性生成"区别在于,模型可以根据中间结果动态调整策略。比如搜索"2026年最新大模型排名"后发现信息不够,可以换一个关键词再搜,而不是硬着头皮编。
下面是一个最小化的ReAct Agent实现,帮你理解底层逻辑:
import json
from openai import OpenAI

client = OpenAI()

# 定义Agent可用的工具集
tools = [
    {
        "type": "function",
        "function": {
            "name": "search_web",
            "description": "搜索互联网获取最新信息",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "搜索关键词"}
                },
                "required": ["query"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "execute_code",
            "description": "执行Python代码并返回结果",
            "parameters": {
                "type": "object",
                "properties": {
                    "code": {"type": "string", "description": "要执行的Python代码"}
                },
                "required": ["code"]
            }
        }
    }
]

# 工具执行映射
tool_map = {
    "search_web": lambda args: f"搜索结果: {args['query']} 的相关信息...",
    "execute_code": lambda args: f"代码执行完成"
}

def react_agent(user_query: str, max_turns: int = 10) -> str:
    """ReAct模式的Agent核心循环"""
    messages = [
        {"role": "system", "content": "你是一个能搜索和执行代码的助手。请逐步推理并完成任务。"},
        {"role": "user", "content": user_query}
    ]

    for turn in range(max_turns):
        response = client.chat.completions.create(
            model="gpt-4.1",
            messages=messages,
            tools=tools,
            tool_choice="auto"
        )
        msg = response.choices[0].message

        # 如果模型决定不调用工具,说明任务完成
        if not msg.tool_calls:
            return msg.content

        # 将助手的工具调用加入历史
        messages.append(msg)

        # 逐个执行工具调用并收集结果
        for tool_call in msg.tool_calls:
            func_name = tool_call.function.name
            func_args = json.loads(tool_call.function.arguments)
            result = tool_map[func_name](func_args)

            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,
                "content": str(result)
            })

return "达到最大轮次限制,任务未完成。"这段代码实现了ReAct的核心循环。关键点在于:max_turns控制循环上限,防止Agent陷入死循环;tool_choice="auto"让模型自己决定什么时候需要调用工具;每次工具执行的结果通过role: "tool"反馈给模型,形成完整的Observation。实际生产中,你还需要加上错误处理、超时机制和结果缓存。
2.2 Function Calling:让AI长出手脚
Function Calling是Agent连接外部世界的桥梁。大模型本身是一个"被关在屋子里"的语言模型——它不能上网、不能读文件、不能发邮件。Function Calling的本质是让模型输出结构化的函数调用指令,然后由外部执行器去真正执行。
# 定义一个完整的工具集:研究员Agent的工具箱
research_tools = [
    {
        "type": "function",
        "function": {
            "name": "arxiv_search",
            "description": "搜索arXiv论文库,获取学术论文信息",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {
                        "type": "string",
                        "description": "论文搜索关键词,建议使用英文"
                    },
                    "max_results": {
                        "type": "integer",
                        "description": "返回结果数量,默认5",
                        "default": 5
                    },
                    "sort_by": {
                        "type": "string",
                        "enum": ["relevance", "date"],
                        "description": "排序方式:相关性或发布日期"
                    }
                },
                "required": ["query"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "github_search",
            "description": "搜索GitHub仓库,获取项目Stars、描述等信息",
            "parameters": {
                "type": "object",
                "properties": {
                    "query": {"type": "string", "description": "仓库名或关键词"},
                    "language": {
                        "type": "string",
                        "description": "编程语言过滤,如python, typescript"
                    }
                },
                "required": ["query"]
            }
        }
    },
    {
        "type": "function",
        "function": {
            "name": "fetch_url",
            "description": "抓取指定URL的网页内容并返回Markdown格式",
            "parameters": {
                "type": "object",
                "properties": {
                    "url": {"type": "string", "description": "目标网页URL"},
                    "max_length": {
                        "type": "integer",
                        "description": "返回内容的最大字符数",
                        "default": 5000
                    }
                },
                "required": ["url"]
            }
        }
    }
]
上面这段代码定义了一个"研究员Agent"的完整工具集。每个工具通过JSON Schema精确描述参数类型、必填项和默认值——模型依赖这些描述来决定如何调用。注意arxiv_search的sort_by字段用了enum限制可选值,这能大幅降低模型"幻觉"出非法参数的概率。实际项目中,一个Agent通常配备3-8个工具,太多会让模型在选择时"犯晕"。
2.3 协议层:MCP与A2A——Agent世界的HTTP
如果说Function Calling解决的是Agent"怎么用手"的问题,那MCP和A2A解决的就是Agent之间"怎么说话"的问题。这是2026年Agent生态最重要的基础设施。
MCP(Model Context Protocol) 由Anthropic发布,定位是Agent连接外部工具和数据源的标准化协议。你可以把它类比为USB接口——不管什么设备,插上就能用。在MCP之前,每个Agent框架都有一套自己的工具接入方式,开发者要为LangChain写一套集成、为CrewAI写一套、为AutoGen又写一套。MCP统一了这个过程:一个MCP Server封装好工具能力,任何支持MCP的Agent框架都能直接调用。
# MCP Server示例:将本地文件系统暴露为Agent工具
from mcp.server import Server, NotificationOptions
from mcp.server.models import InitializationOptions
from mcp.types import Tool, TextContent

server = Server("filesystem-server")

@server.list_tools()
async def list_tools() -> list[Tool]:
    return [
        Tool(
            name="read_file",
            description="读取指定路径的文件内容",
            inputSchema={
                "type": "object",
                "properties": {
                    "path": {"type": "string", "description": "文件绝对路径"}
                },
                "required": ["path"]
            }
        ),
        Tool(
            name="list_directory",
            description="列出目录下的所有文件和子目录",
            inputSchema={
                "type": "object",
                "properties": {
                    "path": {"type": "string", "description": "目录路径"},
                    "recursive": {
                        "type": "boolean",
                        "description": "是否递归列出子目录",
                        "default": False
                    }
                },
                "required": ["path"]
            }
        )
    ]

@server.call_tool()
async def call_tool(name: str, arguments: dict) -> list[TextContent]:
    if name == "read_file":
        with open(arguments["path"], "r", encoding="utf-8") as f:
            content = f.read()
        return [TextContent(type="text", text=content)]
    elif name == "list_directory":
        import os
        path = arguments["path"]
        entries = os.listdir(path)
        return [TextContent(type="text", text="\n".join(entries))]
    raise ValueError(f"Unknown tool: {name}")
这个MCP Server把文件系统的"读文件"和"列目录"两个能力封装成标准工具。任何支持MCP的Agent(不管是Claude、GPT还是Qwen驱动的)都能直接调用,不需要额外写集成代码。inputSchema就是标准的JSON Schema,跟Function Calling的参数定义一模一样。
A2A(Agent-to-Agent Protocol) 由Google在2026年初发布,解决的是不同Agent之间如何发现彼此、协商任务、传递消息的问题。如果说MCP是Agent和工具之间的协议,那A2A就是Agent和Agent之间的协议。
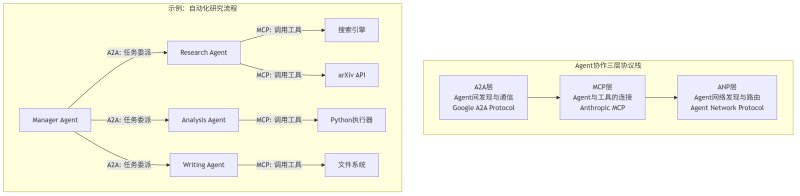
上面这个架构图展示了三层协议栈的关系:ANP在最底层负责Agent在网络中的发现和路由(类似DNS);MCP在中间层负责Agent与外部工具的标准化连接(类似USB);A2A在最上层负责Agent之间的任务协调和消息传递(类似HTTP)。右侧展示了一个实际的研究流程:Manager Agent通过A2A协议把任务分发给三个专职Agent,每个Agent再通过MCP调用各自需要的工具。
三、2026主流框架横向对比:选哪个?
搞懂了底层原理,接下来看框架选型。2026年的Agent框架已经非常丰富了,但真正在生产环境验证过的主要有这几个:
3.1 六大框架核心定位
| 框架 | 开发者 | 核心理念 | 最佳场景 | GitHub Stars |
|---|---|---|---|---|
| LangGraph | LangChain | 基于有向图的精细控制流 | 金融决策、法律审批等需要严格流程控制的场景 | 15k+ |
| CrewAI | CrewAI Inc | 角色扮演+流程驱动 | 内容生产、市场分析等快速原型 | 25k+ |
| OpenAI Agents SDK | OpenAI | 轻量级、代码优先 | 快速构建基于GPT的Agent | 10k+ |
| Google ADK | 模块化、Gemini深度集成 | Google生态企业应用 | 8k+ | |
| PydanticAI | Pydantic | 类型安全+开发体验 | 后端微服务集成、需要强类型保证的场景 | 12k+ |
| AutoGen/AG2 | 微软 | 对话式多Agent协作 | Azure生态企业应用、研究实验 | 40k+ |
3.2 选型决策树
选框架不是看哪个Stars多就选哪个,关键是你的场景。
如果你要做金融/法律/医疗这类对流程控制要求极高的场景——选LangGraph。它的核心抽象是有向图(DAG),每个节点是一个Agent或处理步骤,边是条件跳转。你可以精确控制"先走A还是先走B""如果C失败了回退到哪一步"。它还内置了Checkpointing(状态持久化),能把Agent的中间状态存到PostgreSQL,即使服务器重启也能从断点恢复。这是生产环境最关键的能力之一。
如果你要做内容创作、市场调研、竞品分析这类"角色分工明确"的场景——选CrewAI。它的设计哲学是"像组建团队一样组建Agent":你定义每个Agent的角色(Role)、目标(Goal)和背景故事(Backstory),框架自动处理Agent之间的任务委派和协作。上手门槛极低,一个下午就能搭出一个能跑的原型。
如果你是后端工程师,对类型安全有执念——选PydanticAI。它把Agent的输入输出与Pydantic模型深度绑定,在编译阶段就能发现类型错误。2026年的后端圈子里,PydanticAI是最受关注的新秀。
如果你重度依赖Google Cloud和Gemini——选Google ADK。它跟Gemini、Google Maps、Google Search的集成深度是其他框架比不了的。2026年初刚发布了Java 1.0版本,说明Google在企业市场的野心。
这里给一个更直观的对比:
# ============ 方式1: CrewAI —— 角色驱动的多Agent ============
from crewai import Agent, Task, Crew, Process

# 定义角色——就像写JD(岗位描述)
researcher = Agent(
    role="AI技术研究员",
    goal="搜索并整理最新的AI技术动态",
    backstory="你是一位有10年经验的资深技术研究员,擅长从海量信息中提炼关键洞察。",
    tools=[search_tool, arxiv_tool],
    llm="gpt-4.1",
    verbose=True
)

writer = Agent(
    role="技术编辑",
    goal="将研究结果转化为清晰易懂的技术文章",
    backstory="你是前知名科技媒体资深编辑,擅长将复杂技术讲给普通开发者听。",
    llm="claude-sonnet-4-6",
    verbose=True
)

# 定义任务——自然语言描述即可
research_task = Task(
    description="搜索2026年最值得关注的3个AI Agent框架更新,"
                "包括核心特性、性能数据和GitHub地址",
    agent=researcher,
    expected_output="包含框架名称、核心特性、Star数量、近期更新的结构化报告"
)

write_task = Task(
    description="基于研究结果,写一篇面向开发者的技术速报,"
                "800字以内,需要包含代码示例和对比表格",
    agent=writer,
    expected_output="Markdown格式的技术速报文章"
)

# 组建团队——Crew自动处理任务委派和协作
crew = Crew(
    agents=[researcher, writer],
    tasks=[research_task, write_task],
    process=Process.sequential  # 按顺序执行:先调研再写
)

result = crew.kickoff()这段CrewAI代码展示了"角色驱动"的核心思路。你只需要定义"谁负责什么",不需要操心"消息怎么传递""工具怎么调度"——框架帮你搞定。Process.sequential表示串行执行(先调研再写作),你也可以用Process.hierarchical启用层级管理模式,由一个Manager Agent自动分配任务。
# ============ 方式2: LangGraph —— 图驱动的精细控制流 ============
from typing import TypedDict, Annotated
from langgraph.graph import StateGraph, END
from langgraph.checkpoint.postgres import PostgresSaver
import operator

# 定义共享状态——所有Agent的"黑板"
class ResearchState(TypedDict):
    query: str
    search_results: list[str]
    analysis: str
    final_report: str
    messages: Annotated[list, operator.add]

# Agent节点:研究员
def research_node(state: ResearchState) -> dict:
    """执行搜索并整理结果"""
    results = search_tool.invoke(state["query"])
    return {
        "search_results": results,
        "messages": [{"role": "researcher", "content": f"搜索完成,找到{len(results)}条结果"}]
    }

# Agent节点:分析师
def analysis_node(state: ResearchState) -> dict:
    """基于搜索结果进行深度分析"""
    analysis = llm.invoke(
        f"基于以下搜索结果进行技术分析:\n"
        f"{chr(10).join(state['search_results'])}"
    )
    return {
        "analysis": analysis,
        "messages": [{"role": "analyst", "content": "分析完成"}]
    }

# 条件路由:判断是否需要重新搜索
def should_retry(state: ResearchState) -> str:
    if len(state.get("search_results", [])) < 3:
        return "research"  # 结果太少,重新搜索
    return "analyze"

# 构建有向图
builder = StateGraph(ResearchState)
builder.add_node("research", research_node)
builder.add_node("analyze", analysis_node)

# 设置边和条件路由
builder.set_entry_point("research")
builder.add_conditional_edges("research", should_retry)
builder.add_edge("analyze", END)

# 启用PostgreSQL持久化——支持断点续跑
with PostgresSaver.from_conn_string("postgresql://localhost/agent_db") as checkpointer:
    graph = builder.compile(
        checkpointer=checkpointer,
        interrupt_before=["analyze"]  # 分析前暂停,等待人工确认
    )

    result = graph.invoke(
        {"query": "2026年最佳Multi-Agent框架对比"},
        config={"configurable": {"thread_id": "research-001"}}
)这段LangGraph代码展示了完全不同的设计思路。ResearchState是一个共享的"黑板",所有Agent通过读写这个黑板来交换信息。should_retry是一个条件路由函数——研究员搜索完后,如果结果太少,图会自动回跳到研究员节点重新搜索。interrupt_before=["analyze"]让系统在执行分析前暂停,等待人工确认搜索结果质量,确认后才继续——这就是Human-in-the-loop。配合PostgreSQL持久化,即使服务器在等待期间重启,人工确认后系统也能从断点无缝恢复。
3.3 一个容易踩的坑:别用"万能Agent"
很多初学者会犯一个错误:把所有工具都挂到一个Agent上,让它"全能"。这跟让一个人同时当产品经理、设计师、工程师、QA一样——不是不行,但效率极低,出错率极高。
正确的做法是专业化分工:每个Agent只配备跟它角色相关的工具,只处理它擅长的任务。研究员Agent只需要搜索工具和论文API,不需要写文件的权限;写作Agent只需要文件系统和模板引擎,不需要搜索能力。这不仅是效率问题,更是安全问题——如果研究Agent被注入了恶意Prompt,它无法直接操作文件系统,攻击面就被限制住了。
四、实战:搭建一个自动化技术研究团队
理论讲够了,动手搭一个。下面我们用LangGraph构建一个三角色AI研究团队:研究员负责搜索和整理资料,分析师负责技术深度分析,编辑负责生成最终报告。
4.1 系统架构设计
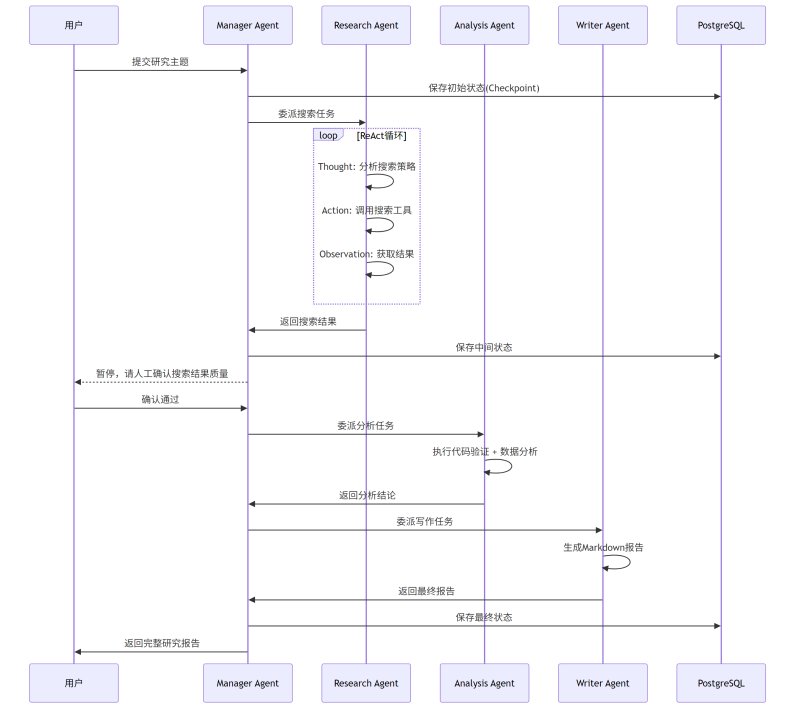
这个时序图展示了完整的工作流程。注意Manager Agent的角色——它不直接执行任何任务,而是负责协调三个专职Agent的执行顺序、传递中间结果、在关键节点暂停等待人工确认。PostgreSQL在每个关键步骤后保存状态(Checkpoint),确保系统在任意时刻断电都能恢复。
4.2 完整代码实现
下面是完整的系统实现代码,包含状态管理、Agent定义、图构建和持久化配置:
"""
Multi-Agent 技术研究团队
基于 LangGraph 2026 最新API
依赖: pip install langgraph langchain-openai psycopg2-binary
"""
from typing import TypedDict, Annotated, Literal
from langgraph.graph import StateGraph, END
from langgraph.checkpoint.postgres import PostgresSaver
from langchain_openai import ChatOpenAI
import operator
import json

# ============ 1. 定义共享状态 ============
class TeamState(TypedDict):
    topic: str                                    # 研究主题
    search_queries: list[str]                     # 搜索关键词列表
    raw_results: Annotated[list[str], operator.add]  # 原始搜索结果(累加)
    key_findings: list[dict]                      # 提取的关键发现
    analysis: str                                 # 深度分析结果
    code_examples: list[str]                      # 生成的代码示例
    report: str                                   # 最终报告
    revision_count: int                           # 修订次数
    messages: Annotated[list[dict], operator.add] # Agent间通信记录

# ============ 2. 初始化模型 ============
llm_smart = ChatOpenAI(model="gpt-4.1", temperature=0.1)       # 研究和分析用
llm_creative = ChatOpenAI(model="claude-sonnet-4-6", temperature=0.7)  # 写作用

# ============ 3. 定义Agent节点 ============
def research_node(state: TeamState) -> dict:
    """研究员Agent:搜索并提取关键信息"""
    prompt = f"""你是一位AI技术研究专家。
    主题: {state['topic']}

    请生成3个最有效的搜索查询来收集该主题的最新信息。
    返回JSON格式: {{"queries": ["query1", "query2", "query3"]}}"""

    response = llm_smart.invoke(prompt)
    queries = json.loads(response.content)["queries"]

    # 模拟搜索(实际项目中替换为真实搜索API调用)
    results = []
    for q in queries:
        results.append(f"[搜索: {q}] 找到5篇相关文章...")

    # 提取关键发现
    extract_prompt = f"""基于以下搜索结果,提取5个最关键的技术发现。
    每个发现包含: title(标题), content(内容), source(来源)

    搜索结果:
    {chr(10).join(results)}"""

    findings = json.loads(llm_smart.invoke(extract_prompt).content)

    return {
        "search_queries": queries,
        "raw_results": results,
        "key_findings": findings,
        "messages": [{"agent": "researcher", "action": "搜索完成", "findings": len(findings)}]
    }

def analysis_node(state: TeamState) -> dict:
    """分析师Agent:深度技术分析"""
    findings_text = json.dumps(state["key_findings"], ensure_ascii=False, indent=2)

    prompt = f"""你是一位资深技术分析师。基于以下研究发现,提供深度技术分析。

    要求:
    1. 技术原理剖析(底层架构、核心算法)
    2. 与竞品的对比分析(至少3个维度)
    3. 实际应用场景和落地难度评估
    4. 未来6-12个月的发展预测

    研究发现:
    {findings_text}"""

    analysis = llm_smart.invoke(prompt).content

    # 生成配套代码示例
    code_prompt = f"""基于分析内容,生成2个实用的代码示例。
    每个示例20-40行,覆盖不同技术点。
    返回JSON: {{"examples": ["code1", "code2"]}}

    分析内容: {analysis[:2000]}"""

    code_examples = json.loads(llm_smart.invoke(code_prompt).content)["examples"]

    return {
        "analysis": analysis,
        "code_examples": code_examples,
        "messages": [{"agent": "analyst", "action": "分析完成"}]
    }

def writing_node(state: TeamState) -> dict:
    """编辑Agent:生成最终报告"""
    prompt = f"""你是一位技术自媒体编辑。基于以下素材撰写技术文章。

    要求:
    - 开头用场景或数据切入,不要用"近年来"开头
    - 正文不少于2000字
    - 包含代码示例和对比表格
    - 语言专业但不晦涩,像资深工程师面对面聊技术

    分析素材:
    {state['analysis']}

    代码示例:
    {chr(10).join(state['code_examples'])}"""

    report = llm_creative.invoke(prompt).content

    return {
        "report": report,
        "messages": [{"agent": "writer", "action": "报告生成完成"}]
    }

# ============ 4. 条件路由 ============
def route_after_research(state: TeamState) -> Literal["analyze", "retry"]:
    """搜索结果质量检查"""
    if len(state.get("key_findings", [])) < 3:
        return "retry"    # 发现太少,重新搜索
    return "analyze"      # 质量合格,进入分析

def quality_check(state: TeamState) -> Literal["write", "revise"]:
    """分析质量检查"""
    if len(state.get("analysis", "")) < 500:
        return "revise"   # 分析太浅,要求修订
    return "write"        # 质量合格,进入写作

# ============ 5. 构建工作流图 ============
builder = StateGraph(TeamState)

# 添加节点
builder.add_node("research", research_node)
builder.add_node("analyze", analysis_node)
builder.add_node("write", writing_node)

# 设置入口和边
builder.set_entry_point("research")
builder.add_conditional_edges("research", route_after_research)
builder.add_conditional_edges("analyze", quality_check)
builder.add_edge("write", END)

# ============ 6. 编译并运行 ============
DB_URI = "postgresql://user:pass@localhost:5432/agent_team"

with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    app = builder.compile(
        checkpointer=checkpointer,
        interrupt_before=["analyze"]  # 分析前暂停,等待人工确认
    )

    # 启动研究任务
    result = app.invoke(
        {"topic": "2026年Multi-Agent框架最新技术演进", "revision_count": 0},
        config={"configurable": {"thread_id": "research-2026-04-02"}}
    )

    print(f"研究完成! 报告长度: {len(result['report'])}字")
这段代码是一个完整的Multi-Agent研究团队的骨架。几个关键设计决策值得单独说明:
共享状态模式(Blackboard Pattern):TeamState充当一块"黑板",所有Agent都可以读取和追加信息。Annotated[list[str], operator.add]表示这个字段是累加的——多个Agent的结果会自动合并而不是覆盖。这避免了"后一个Agent覆盖前一个Agent数据"的常见Bug。
条件路由:route_after_research和quality_check两个函数充当"质检员"——Agent完成任务后,不是直接进入下一步,而是先过质量检查。如果搜索结果太少就重试,如果分析太浅就要求修订。这种"检查-回退"机制是生产环境Agent系统的标配。
模型分层调用:研究和分析用gpt-4.1(精度高、速度快),写作用claude-sonnet-4-6(创意性好、文字流畅)。不同Agent用不同模型是Multi-Agent的天然优势——你不需要为所有任务都付最贵模型的钱。
五、生产环境必须搞定的三件事
Demo好写,生产难上。把Multi-Agent系统真正部署到生产环境,有三件事你必须搞定。
5.1 状态持久化:Agent不能"失忆"
开发环境的Agent跑在内存里,进程一杀就没了。但生产环境的业务流程可能跨越数天甚至数周(比如法律合同审核、跨国供应链跟踪)。如果Agent在第二天需要"记住"第一天的分析结果,就必须有持久化方案。
LangGraph的PostgresSaver是目前最成熟的方案。它的工作原理是:在图的每个节点执行完毕后,将完整的State快照序列化存入PostgreSQL。恢复时,通过thread_id找到最近的Checkpoint,反序列化后继续执行。
这意味着你可以做到:周五下午提交一个研究任务,Agent完成搜索后暂停;周一上班后人工确认搜索结果,Agent从数据库恢复状态继续分析——中间没有任何信息丢失。
5.2 可观测性(AgentOps):揪出"沉默的Token杀手"
多Agent系统最可怕的Bug不是报错,而是"沉默的浪费"——Agent A和Agent B陷入循环推诿,每次调用都在消耗Token,但任务毫无进展。或者一个Agent反复搜索同一个页面10次,你却毫不知情。
解决这个问题的工具:
- LangSmith:LangChain生态的原生可观测性平台,能可视化展示完整的Agent调用链路(Trace),每个节点的输入输出、耗时、Token消耗一目了然。
- AgentOps:专注于多Agent团队的监控,提供Agent活跃度、任务成功率和Token损耗的实时看板。它还能设置"熔断"规则——如果一个Agent连续5次没有产出有效结果,自动终止该Agent。
5.3 安全围栏(Guardrails):Agent间的"零信任"
Multi-Agent意味着攻击面倍增。如果一个联网的调研Agent被恶意Prompt注入,它可能诱导财务Agent执行未授权的支付操作。安全围栏的核心思想是"零信任"——Agent之间的每一次通信、每一次工具调用都要经过独立的审计。
目前主流的方案包括Guardrails AI(Input/Output扫描层,像防火墙一样过滤Agent交互)和PydanticAI的编译时类型检查(在代码运行前就杜绝不合规的工具调用)。
一个实用的安全策略是最小权限原则:每个Agent只拥有完成本职工作所需的最小工具集。研究员只能搜索和读取,不能写文件;编辑只能写文件,不能调用支付API;财务Agent才能执行支付操作。配合MCP的权限控制层,你可以精确到"某个Agent只能读取某个目录下的某个文件"这种粒度。
六、写在最后:从执行者到架构师
回顾一下这篇文章的关键内容:
我们拆解了Multi-Agent的三个核心层:ReAct模式让单个Agent能"边想边做",Function Calling让它能"长出手脚",MCP/A2A协议让多个Agent能"互相沟通"。在框架选型上,LangGraph适合需要精细控制的生产场景,CrewAI适合快速原型,PydanticAI适合后端工程师的强类型需求。生产部署要搞定状态持久化、可观测性和安全围栏三件事。
几个值得继续思考的问题:
第一,Agent经济什么时候到来? 零一万物预测到2027年,互联网上超过50%的流量将由Agent产生——Agent代替主人购物、投简历、甚至社交。当Agent成为互联网的主要"用户",现有的产品形态会怎么变化?
第二,多Agent协作的天花板在哪? 目前主流的多Agent系统规模在3-10个Agent之间。当Agent数量扩展到100个甚至1000个时,通信开销和协调成本会不会抵消掉分工带来的效率提升?分布式系统领域的CAP定理在Agent世界是否有类似的约束?
第三,协议战争的终局是什么? MCP、A2A、ANP三个协议分别由Anthropic、Google和社区推动。它们会像HTTP一样统一成一个标准,还是会像编程语言一样长期共存?Agent框架之间的互操作性到底能走多远?
2026年的Multi-Agent浪潮给了开发者一个独特的机会:从一个"写代码的执行者",变成一个"编排AI团队的架构师"。这个转变可能比学会任何一个新框架都重要。
参考链接:
- LangGraph官方文档: https://langchain-ai.github.io/langgraph/
- CrewAI GitHub仓库: https://github.com/crewAIInc/crewAI
- Anthropic MCP协议规范: https://modelcontextprotocol.io/
- Google A2A协议公告: https://developers.googleblog.com/en/a2a-a-new-era-of-agent-interoperability/
- Google ADK文档: https://google.github.io/adk-docs/
- PydanticAI文档: https://ai.pydantic.dev/
- 智源2026十大AI技术趋势: http://www.news.cn/tech/20260108/b99127c88a4640bbab49e5c6294264d2/c.html
- 清华大学2026中国AI发展趋势前瞻: https://www.tsinghua.edu.cn/info/1182/124190.htm
- 零一万物企业多智能体预判: https://zhuanlan.zhihu.com/p/1991548096589632113
- 2026 Multi-Agent框架深度选型指南: https://www.cnblogs.com/AJun816/p/19678341
- AWS Builder Center - Agent框架选型2026: https://builder.aws.com/content/3AzsgG6TreTO3uLRqpWNxfEyUhe/picking-an-ai-agent-framework-in-2026