一、生成式AI工程化智能体很美,业务应用却一地鸡毛
投入百万搭建大模型,上线后频繁出现 “幻觉”:
- 查客户数据张冠李戴、核算营收凭空多出费用、给业务决策编造不存在的行业规则;
- CRM、ERP、财务系统各说各话,同一个 “客户” 两套统计口径,数据工程师 80% 时间耗在清洗对齐;
- Prompt 写烂、RAG 反复调参、砸钱做微调,短期见效,长期依然不稳定,一上生产就翻车。
不是模型不够强,不是数据不够多。中间隔着的,是一套属于企业自身的、结构化的业务世界观。
绝大多数大模型 Agent,本质是聊天工具,只会检索文本、瞎推理,分不清相关性和因果,业务复杂一点直接翻车,决策黑箱没法审计,涉密、金融场景根本不敢用。
这套世界观,有一个被忽视了三十年的名字:本体论(Ontology)。
本体不是简单知识图谱,是一套动态可执行的业务数字孪生,把企业所有业务对象、流程、规则、权限全部标准化。LLM 只是上层推理工具,可随意替换 GPT、Claude、开源模型,不会被单一厂商锁死。
有本体做地基,AI 所有推理都绑定真实业务定义,不会脱离现实乱编,解决大模型幻觉致命问题。
二、大模型的本质:一只统计"鹦鹉"
要理解本体论为什么突然变得重要,先得看清大模型到底在做什么。
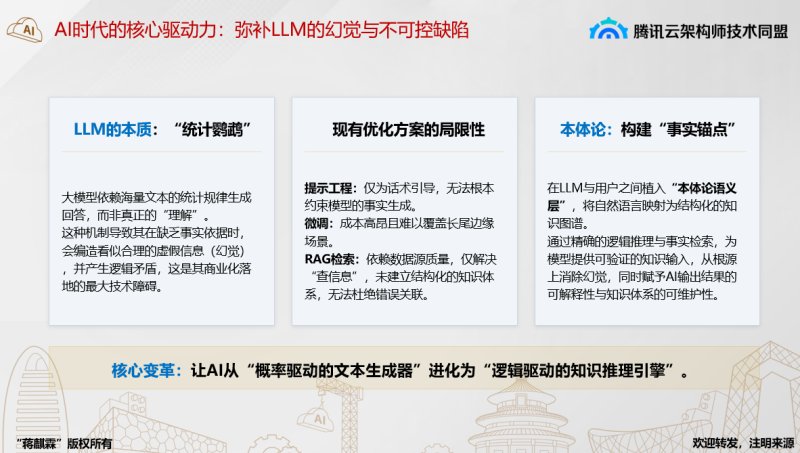
2021年,语言学家艾米丽·本德(Emily Bender)在论文中提出"随机鹦鹉"(Stochastic Parrot)概念:大语言模型本质上是在海量文本中学习词语的共现概率分布,然后按概率规则拼接词串。它操纵的是语言的形式,却从不触及语言的意义。
从本体论视角审视,这一局限更加清晰:大模型是一个"无主体的符号操作实体":它没有主体意识,没有与真实世界的交互经验,只掌握符号之间的统计关联,不知道符号在现实世界中的指涉对象。它说出"苹果"这个词,不是因为它咬过苹果,而是因为"苹果"这个词在训练语料中经常与特定词串共同出现。
由此可以推出一个重要结论:AI幻觉不是技术bug,而是大模型的结构性必然。 模型不知道什么概念合法、什么关系成立、什么操作被允许。在缺乏事实依据时,模型会编造看似合理实则虚假的信息。企业员工问模型"公司的报销流程是什么",模型可能编造一套"看起来合理但根本不存在的流程"。
大部分企业至今停留在"买个模型当文本计算器用"的阶段,没有意识到一个关键问题:要给鹦鹉装上“三观”,不能靠换一只更聪明的鹦鹉,而要靠构建外部知识系统与校验机制。
三、本体论为什么当前被软件服务商频繁提起
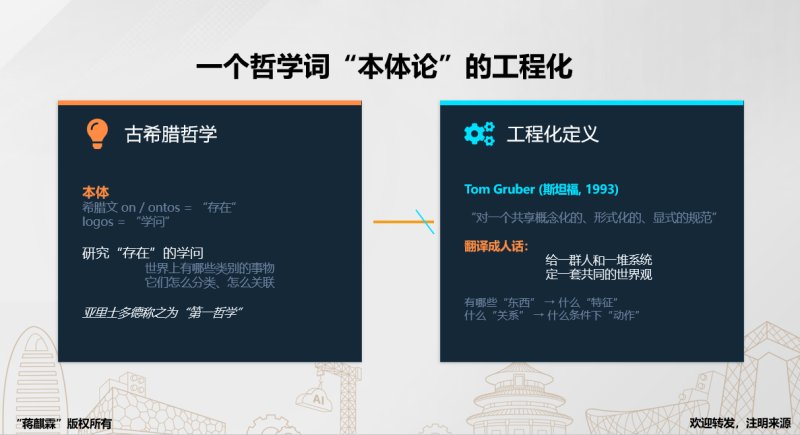
本体论不是新概念。1993年斯坦福的Tom Gruber就给出了工程化定义。但它在今天爆发,是因为痛点够痛,催化剂够猛。
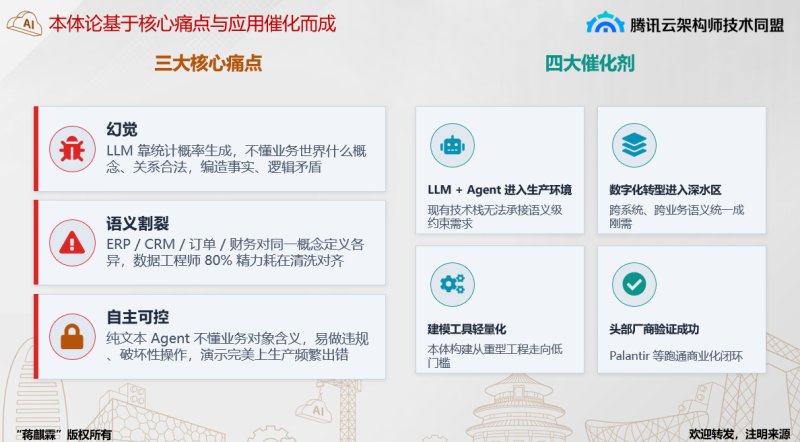
三大核心痛点
第一,幻觉。 LLM靠统计概率生成,不懂业务世界什么概念、关系合法,编造事实、逻辑矛盾。在企业场景里,一次幻觉可能就是一笔错误订单、一条违规操作。
第二,语义割裂。 这是最被低估的隐性成本。ERP、CRM、订单系统、财务系统,对同一个"客户"的定义各不相同。数据工程师80%的精力耗在清洗、对齐、映射上:而这只是"治标"。系统每增加一个,映射规则的复杂度呈几何级上升。
第三,自主可控。 纯文本Agent不懂业务对象的含义。它能匹配关键词,但不知道"删除订单"意味着什么后果。演示时完美,上生产就频繁出错,甚至做违规、破坏性操作。
四大催化剂
光有痛点不够,还得有条件让它落地:
- LLM + Agent进入生产环境——现有技术栈无法承接语义级约束需求,需求被激活。
- 数字化转型进入深水区——跨系统、跨业务语义统一成刚需,不再是锦上添花。
- 建模工具轻量化——本体构建从重型工程走向低门槛,不再需要一队博士才能干。
- 头部厂商验证成功——Palantir等跑通了商业化闭环,证明这条路走得通。
痛点是真痛,条件是真熟。本体论从"学术象牙塔"走向"企业基础设施"的拐点,就在当下。
四、本体论是什么:给混乱的世界,搭一套共同的语义骨架
"本体论"这个词听着玄,其实可以翻译成人话:给一群人和一堆系统,定一套共同的世界观。
它回答四个问题:
- 有什么东西?(实体Entity:客户、订单、库存……)
- 什么特征?(属性Property:对象的字段与类型约束)
- 什么关系?(关系Relation:属于、包含、触发、依赖)
- 什么条件下做什么?(公理Axiom:业务规则,比如"订单总额=培训费+咨询费+工具年费+陪跑费")
举个具体例子。一家工厂有设备、产线、物料、订单、质量事件。定义清楚对象→属性→关系→规则(温度超阈值就报警)之后,所有人、所有系统、所有AI,能在同一套语义上对话。
ERP里的"客户"和CRM里的"客户",不再是两张需要人工映射的表,而是同一个对象。
这就是本体论干的事:打破部门间的"巴别塔",把数据治理从机械的字段对齐,升维为统一的业务共识。
五、本体论的三个实战价值
价值一:破解多系统的"语义混乱"
企业里最常见的灾难,不是数据缺失,而是数据看似都在,但谁也读不懂谁。
同名不同义:CRM里的"客户"指签了合同的企业,ERP里的"客户"指下过采购单的供应商,财务里的"客户"指应收账款对象。同一个词,三个系统三套口径。
异名同义:同一个业务实体,被冠以"用户""买家""会员"三个名字,系统间数据无法自动对齐。
传统方案是维护字段映射表——人工对,人工改,人工背锅。系统一多,映射规则爆炸,最后变成一锅没人敢动的粥。
本体论的解法是单一事实来源:构建企业级统一概念模型,为每个业务术语确立唯一、权威的定义。从"字段对齐"升级为"概念对齐",让数据真正承载业务语义。
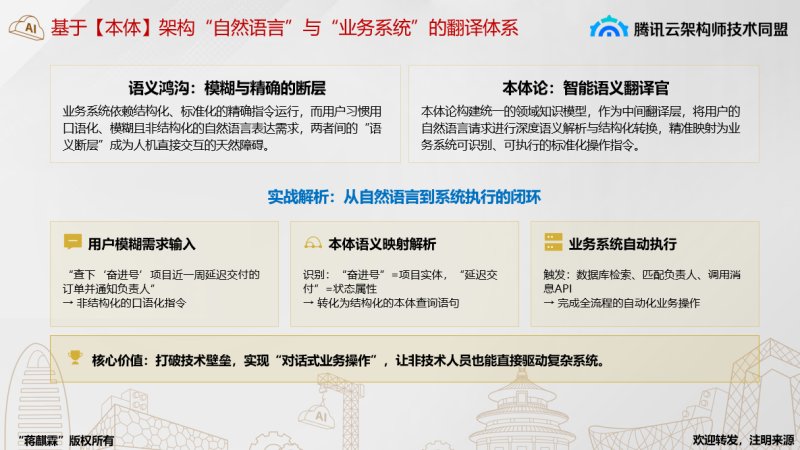
价值二:自然语言与业务系统的"智能翻译官"
业务系统依赖精确的结构化指令运行。用户习惯说人话:"查下'奋进号'项目近一周延迟交付的订单并通知负责人。"
中间隔着一条巨大的语义鸿沟。
本体论作为中间翻译层,做三件事:
- 语义解析——识别"奋进号"=项目实体,"延迟交付"=状态属性
- 结构化转换——转化为系统可识别的查询语句
- 自动执行——触发数据库检索、匹配负责人、调用消息API
结果是:非技术人员也能用一句话驱动复杂系统。技术壁垒被打破,"对话式业务操作"成为现实。
价值三:给Agent一套可计算的业务世界观
这是当下最值钱的一点。
纯文本Agent只懂关键词匹配。本体论让它"懂对象、知约束、明因果":
- 有什么对象——业务实体全集与层级关系
- 能执行什么动作——Action类型与可调用函数
- 前置/后置约束——操作合法性边界与触发条件
- 因果连锁影响——动作引发的下游传导效应
有了这套约束,Agent才能做到自主规划、可追溯、可审计、风险可控。否则它只是一个会闯祸的文本生成器。
六、Palantir已经跑通了这条路
如果说本体论还停留在理论,Palantir用几百亿美元市值给出了商业证明。
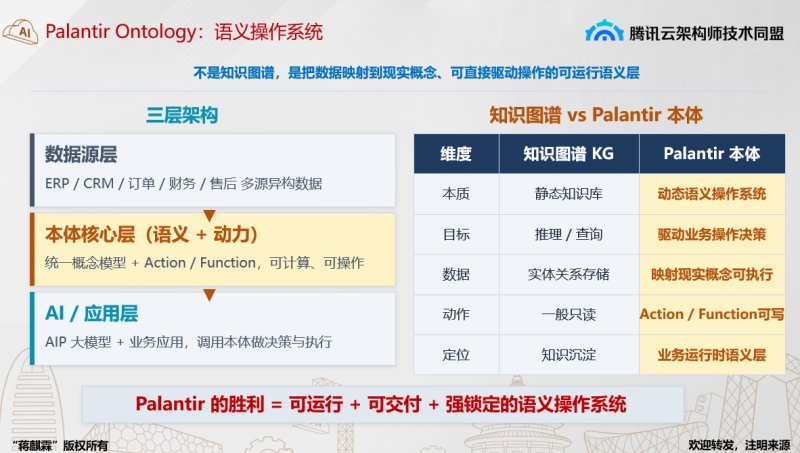
Palantir Foundry的核心,就是把本体置于架构的绝对中心,做成一个"语义操作系统"。它的三层架构值得每个做企业AI的人认真研究:
- 语义层(Semantic Layer):定义业务实体及关联,建立企业级"数据字典",消除语义歧义。
- 行为层(Kinetic Layer):定义实体可执行的原子动作与业务流程,把静态数据变成可交互的业务对象。
- 动态层(Dynamic Layer):内置权限控制、全链路数据血缘追溯与版本管理,保障安全合规可审计。
关键区别在于:Palantir的本体不是知识图谱。知识图谱是"图书馆",Palantir本体是"工厂流水线"。一个用来查,一个用来干。
Palantir的胜利 = 可运行 + 可交付 + 强锁定的语义操作系统。
七、四维价值:谁先建模,谁先拥有"领域大脑"
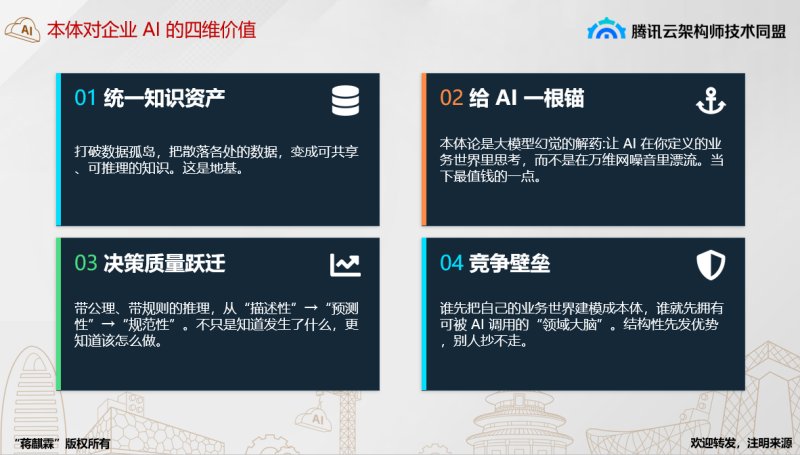
回到企业AI的落地视角,本体论的价值可以浓缩为四句话:
- 1. 统一知识资产。 打破数据孤岛,把散落各处的数据变成可共享、可推理的知识。这是地基。
- 给AI一根锚。 让AI在你定义的业务世界里思考,而不是在万维网噪音里漂流。当下最值钱的一点。
- 决策质量跃迁。 带公理、带规则的推理,从"描述性"→"预测性"→"规范性"。不只是知道发生了什么,更知道该怎么做。
- 竞争壁垒。 谁先把自己的业务世界建模成本体,谁就先拥有可被AI调用的"领域大脑"。这是结构性先发优势,别人抄不走。
八、写在最后
用通用大模型回答"世界的问题",永远存在"一本正经的胡说八道"。
但企业要的不是"世界的问题",而是"我的问题"——在特定行业黑话、企业知识的前提下得到准确答案。
中间隔着的,不是更大的模型,不是更多的数据。
是一套属于自身企业数据资产、结构化的业务世界观。
那套世界观,就是本体论。
这不是技术选型的问题,是认知的问题。当所有人都在卷模型参数、卷数据规模、卷Prompt技巧的时候,真正决定企业AI成败的,可能是一个被遗忘了三十年的老概念。
有时候,最前沿的答案,藏在最古老的地方。