偶然看到网上一篇文章介绍,可以用docker来跑群晖了! https://github.com/kroese/virtual-dsm version: "3" services: dsm: container_name: dsm image: kroese/virtua...
最新博文
用Docker来跑群晖DSM
LLaMA语言模型论文讲解
一、简介 LLaMA是2023年Meta发布的基础LLM模型,该模型有四个版本,分别是7B、13B、33B、65B参数的模型。最近因为模型被泄漏,模型权重可以在网上搜索下载。相对于GPT序...
深度学习中的注意力机制
目录: Attention机制的研究进展 人类的视觉注意力 在图像中使用注意力机制 在NLP中使用注意力机制(必须掌握) 4.1 Encoder-Decoder框架 4.2 Attention机制 (熟练推导...
大模型入门(一)—— LLaMa/Alpaca/Vicuna
LLaMa模型是Meta开源的大模型,模型参数从7B到65B不等,LLaMa-7B在大多数基准测试上超过了GPT3-173B,而LLaMa-65B和Chinchilla-70B、PaLM-540B相比也极具竞争力。相比...
大模型入门(二)—— PEFT
PEFT(Parameter-Efficient Fine-Tuning)是hugging face开源的一个参数高效微调大模型的工具,里面集成了4中微调大模型的方法,可以通过微调少量参数就达到接近微调全...
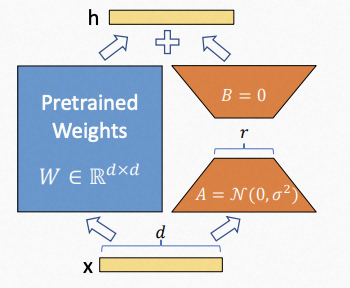
大模型入门(三)—— 大模型的训练方法
参考hugging face的文档介绍:https://huggingface.co/docs/transformers/perf_train_gpu_many#naive-model-parallelism-vertical-and-pipeline-parallelism,以下介绍...
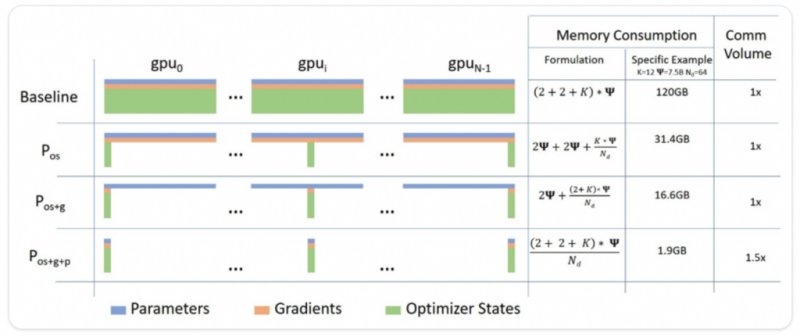
大模型入门(四)—— 基于peft 微调 LLaMa模型
llama-7b模型大小大约27G,本文在单张/两张 16G V100上基于hugging face的peft库实现了llama-7b的微调。 1、模型和数据准备 使用的大模型:https://huggingface.co/dec...
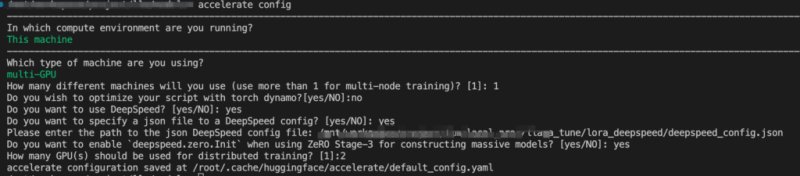
Linux配置pip使用国内镜像加速
在linux系统中,在~/目录下新建文件夹.pip,并新建编辑pip.conf文件,加入如下内容: [global] index-url = https://pypi.tuna.tsinghua.edu.cn/simple/ 示例用的是清华...
使用selenium模拟网页操作,执行重复任务
背景 战网安全令独立服关闭,导致之前没有存储密钥的安全令统统不好用了,经过一番研究发现可以通过反复绑定安全令到战网账号的方式获取到安全令的密钥,但是这个方式需...
nginx-proxy-manager 安装 zope包
在使用npm的时候,ssl证书选择使用Use a DNS Challenge进行认证的时候会有下面这个错误。 ModuleNotFoundError: No module named 'zope' 大概意思是缺少zope这个包,官...