升级完最新系统,刚准备coding,提示让我安装command line developer tools,我就安装了一下,提示安装完成之后,打开命令行,又提示要我安装这个。。 我感觉哪里不对,...
最新博文
反复提示安装 Command Line Developer Tools
升级IntelliJ IDEA 启动之后闪退
想装一个idea插件,发现插件各种报错。 查不到什么原因,看了下我的idea版本,还是2019年的,心想可能是我的版本太低了吧? 看了一眼官网已经出到 2022.2.3了。升级下id...
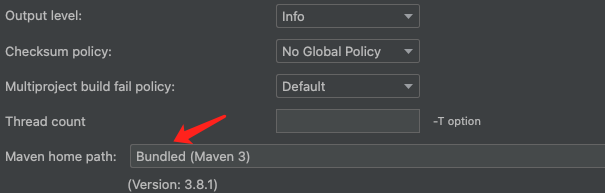
idea升级之后,maven依赖报错 maven-default-http-blocker (http://0.0.0.0/): Blocked mirror for repositories
升级完idea之后,打开项目,很多包找不到,更新maven依赖,提示我:Could not transfer artifact com.xxx:1.7.2 from/to maven-default-http-blocker (http://0.0.0.0/)...
使用cfscrape框架来抓取被Cloudflare保护的网站资源
背景 尝试抓取一个网站的资源做一些分析,发现直接curl或者Python的request请求下来的资源不对,用html打开发现是Cloudflare的一个保护页。有此可知这个网站是被保护了...
使用Python爬虫抓取网站的内容
背景 一直非常喜欢一个网站 https://www.examples.com/,想着这个网站如果突然不在了可怎么办?就想着有什么办法能帮这个网站保存下来。 正好之前玩过Python爬虫,想着...
使用Python提交WordPress文章
1.插件安装 需要安装一个WordPress插件,名字叫:JWT Authentication for WP-API 2.编写代码 首先你需要获取提交文档的一个token。 import requests import json wpBase...
通过wp-json接口抓取WordPress网站数据
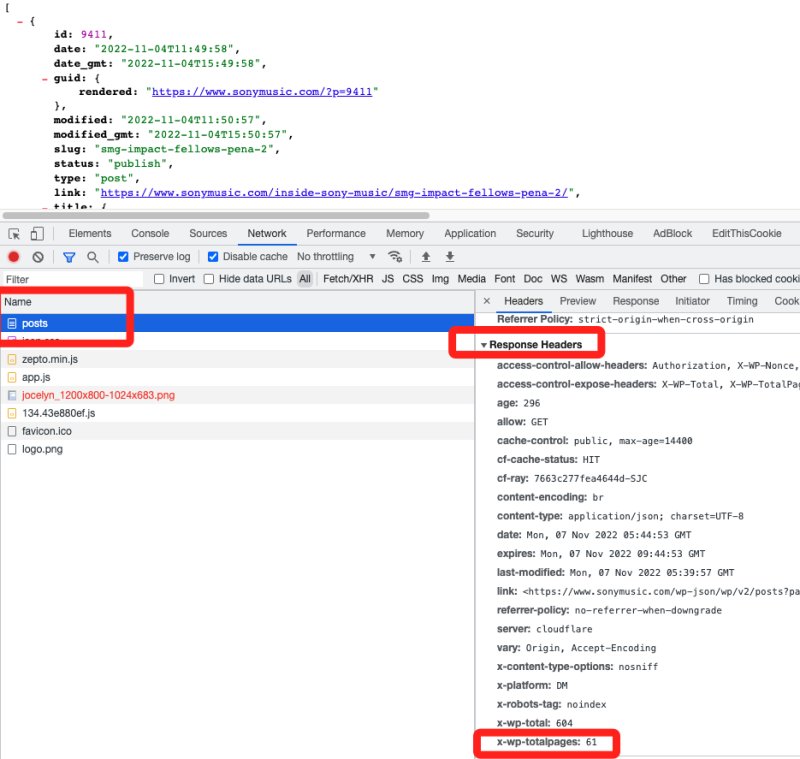
WordPress网站一般会有开放的接口来获取网站元数据 参考:https://developer.wordpress.org/rest-api/reference/posts/ 例如这个样例网站:https://www.sonymusic.com/ ...
python json dump 输出中文
在写爬虫时,使用python自带的json模块将网页中需要的信息输出保存到json文件中,发现json文件中的中文 格式全是类似于”\u5176\u5b83”的形式。可见该模块将输出的中文进...
谷歌翻译插件报错(AttributeError: ‘NoneType’ object has no attribute ‘group’)
偶然机会需要用到Python来翻译资料,调研一番发现googletrans这个插件还不错。 安装好插件,尝试写了个demo -- coding: utf-8 -- from googletrans import Translator t...
Netty 报错:is not a Sharable handler, so can’t be added or removed multiple times
尝试用netty写了个日志收集服务,类似于logstash的功能,因为我们才采集日志的时候可能有很多的策略要去做,logstash的功能不够支撑,所以尝试使用netty自己写。 看了一...