好久没有测试 Gemini 提取字幕的能力了,对 3.8 Flash 这个模型也进行测试
视频时长11分半,不对视频进行切片,一次性导入上下文,多模态分析
第一次 API 调用完成字幕提取
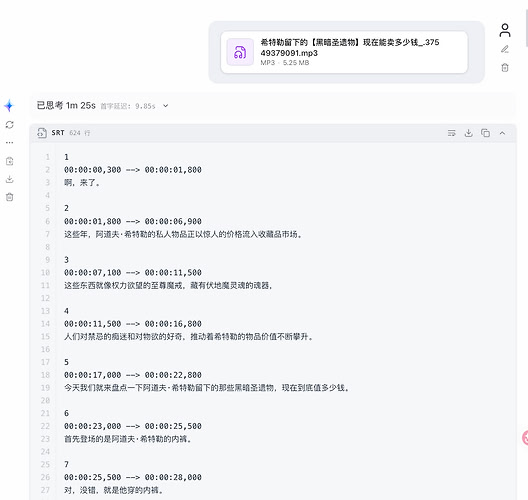
测试一:音频转字幕
拖入音频文件,获取字幕
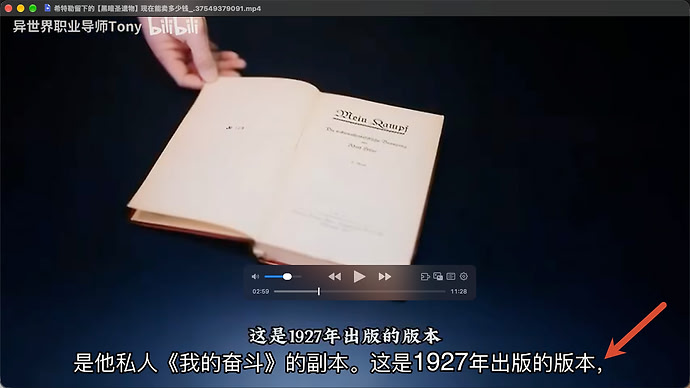
镜头这个位置是AI识别出的字幕
完成该操作时使用了17K的输入和8K的输出
只调用一次API
所有时间戳均准确无误
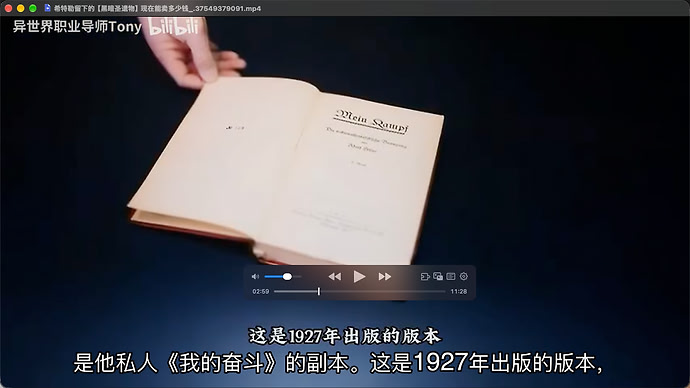
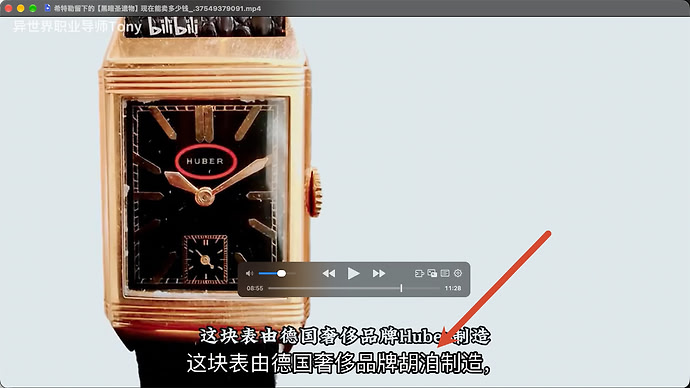
唯一缺点是该专有品牌采用了中文名称,这个中文名在互联网上均无法查询到
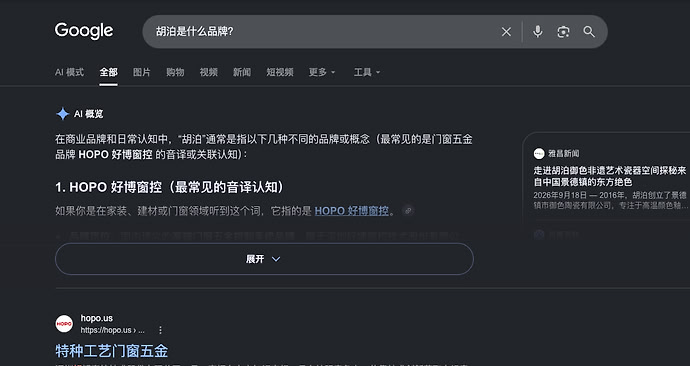
测试二:视频转字幕
直接把视频文件拖入聊天框,可以通过视觉能力理解视频中的内容,这对字幕的提取更有帮助
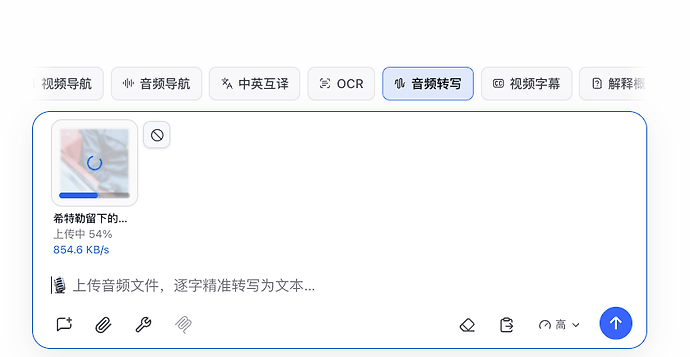
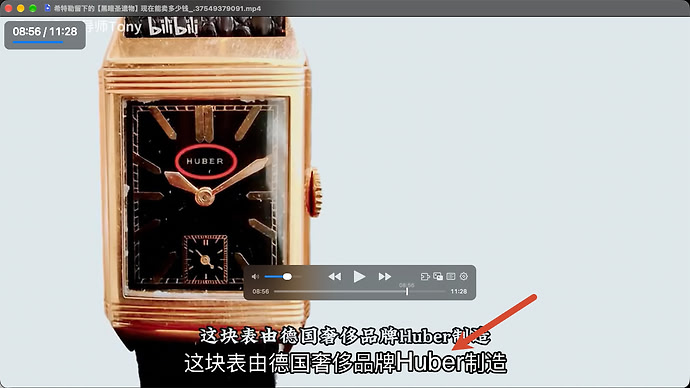
时间戳依然准确,时间戳比视频内嵌的字幕更准
这就更加牛逼了,可以通过画面内容来进行修正
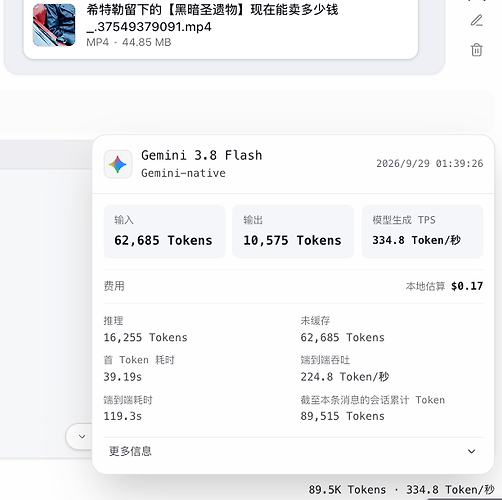
携带视频的情况下,Token 就需要多很多, 62K 输入,10K 输出
如果我是视频创作者,需要为视频添加字幕,那么 Gemini 就是我的唯一选择